你的文本被拆分成Token
Token可以是完整的单词、单词的一部分、标点符号或其他文本单元。这就是为什么字数和Token数量不一样。
代码、数字、符号和不同的书写系统可能与普通英语散文有不同的划分方式。
在使用AI模型内容前,先统计提示词、文档、代码和多语言文本中的Token数量。粘贴文本或上传TXT或Markdown文件,以审查标记、字数和字符数。
AIToken计算器估算文本如何划分为Token,即语言模型处理的较小文本单元。Token计数可能与单词和字符计数不同,尤其是在代码、标点符号和多语言内容方面。
Token可以是完整的单词、单词的一部分、标点符号或其他文本单元。这就是为什么字数和Token数量不一样。
代码、数字、符号和不同的书写系统可能与普通英语散文有不同的划分方式。
粘贴文本,直接输入,或上传支持的文本文件,然后向Unfox服务请求计算。
将结果作为规划参考。当特定模型或API的分词器不同时,所使用的具体计数可能会有所不同。
结果显示了词数以及单词和字符总数,方便你比较多个输入长度的指标。
这在缩短提示、审查文档大小或为基于Token限制的系统准备文本时非常有用。
Token计数帮助你在使用文本前检查提示词和文档长度。它适合编辑、规划和比较同一输入的版本。
在提示词、系统消息、代码片段、JSON 负载或对话历史中计数Token。
利用结果识别可能比必要更长的指令或重复上下文。
在将文章、研究笔记、文档及其他文本添加到AI工作流程前,请审查其大小。
当输入过大时,将其拆分成有意义的部分,分别计算每个部分。
计算一个原始提示和一个较短的修订,看看编辑如何改变Token数量。
这为比较提示长度提供了一种具体方法,而不必仅依赖单词或字符。
检查代码、标点重的文本和多语言内容,单靠字数可能无法判断Token使用。
请记住,模型特定的 API 在使用其他分词器时可能会返回不同的计数。
Token计数在为语言模型工作流程准备提示、文档、代码或对话历史时非常有用。
在发送给AI服务前,检查提示、系统消息、代码、JSON和对话历史。
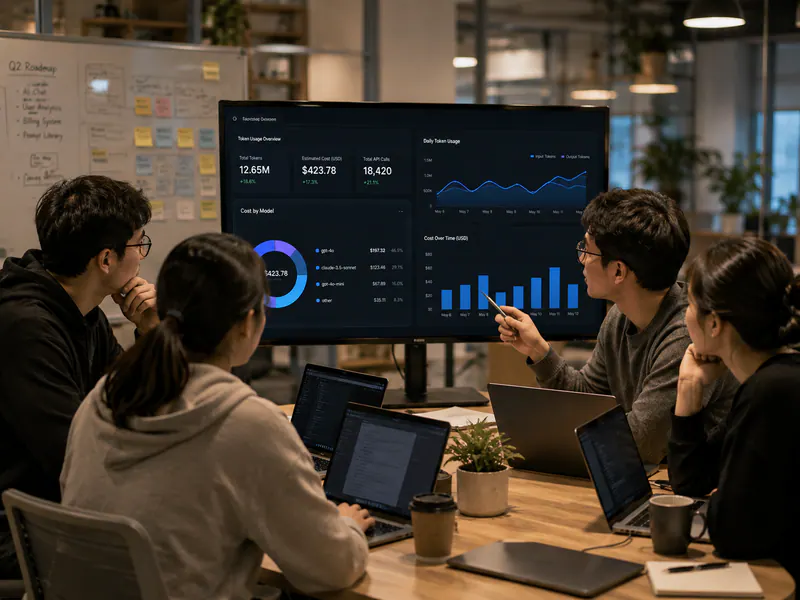
比较常用请求模板的长度,并查看变更如何影响Token使用。
在为AI工具准备文档和工作流程时,使用Token计数作为规划输入。
在使用LLM之前,先统计文章、笔记、文档和日常提示中的Token。
Token计算只是AI内容工作的一部分。探索更多 Unfox 工具,用于检查文本、优化 AI 辅助写作,并分析 AI 生成的图像和音频。
文本会发送到Unfox计算服务以返回Token计数。提交内容前请删除密码、API密钥、个人信息及其他机密材料,并查看隐私政策以获取当前的数据处理细节。 了解更多关于我们如何处理数据的信息 隐私政策.
将标记、单词和字符计数合并为一个结果。
直接粘贴内容,或上传支持的纯文本或Markdown文件。
界面在显示单词时会统计中文、日文和韩文字符。
在浏览器中提交文本,并从计算服务那里获得Token计数。
关于AIToken、Token计数、单词、字符、多语言文本以及型号特定差异的快速回答。
对于典型的英语散文,1000字通常估计约为1300到1500个词元,但这只是一个通用指南。实际计数取决于分词器、语言、标点符号、格式和内容类型。
Token是由语言模型处理的文本单元。它可以是整词、单词的一部分、标点符号、数字或其他文本片段,因此Token计数与单词计数不同。
字符是单个字母、符号和空格;单词是人类可读的单位;Token是分牌器创建的棋子。一个词可以是一个词,也可以是多个词,具体取决于文本和词符器。
不同的模型家族可能使用不同的分词器和词汇表。因此,同一个提示词、代码片段或多语言文本可能产生不同的计数。除非你用精确的模型分词器验证XQZ,否则将Unfox结果视为规划参考。
语言和书写系统可以以不同的方式划分为标记。英语、中文、日语、阿拉伯语以及其他语言在特定分词器下,标记、单词和字符之间可能有不同的关系。
上下文窗口是语言模型在一次请求中能处理的信息量,通常以标记为单位。系统指令、提示、对话历史、文档和生成的输出都可能占用这个限制的一部分。
是的。您可以使用 Unfox AI 标记计算器来计算文本和支持的文本文件中的标记数量。结果还会显示单词和字符总数,提供更多参考信息。
文本将发送到 Unfox 计算服务以返回标记数量。在提交内容之前,请删除密码、API 密钥、个人信息和机密资料,并查看当前隐私政策以了解数据处理细节。